Il Modello che Impara a Dimenticare
Perché cancellare informazioni da un'intelligenza artificiale è uno dei problemi più difficili che l'industria tech stia cercando di risolvere.
Fenix Team5 min di lettura
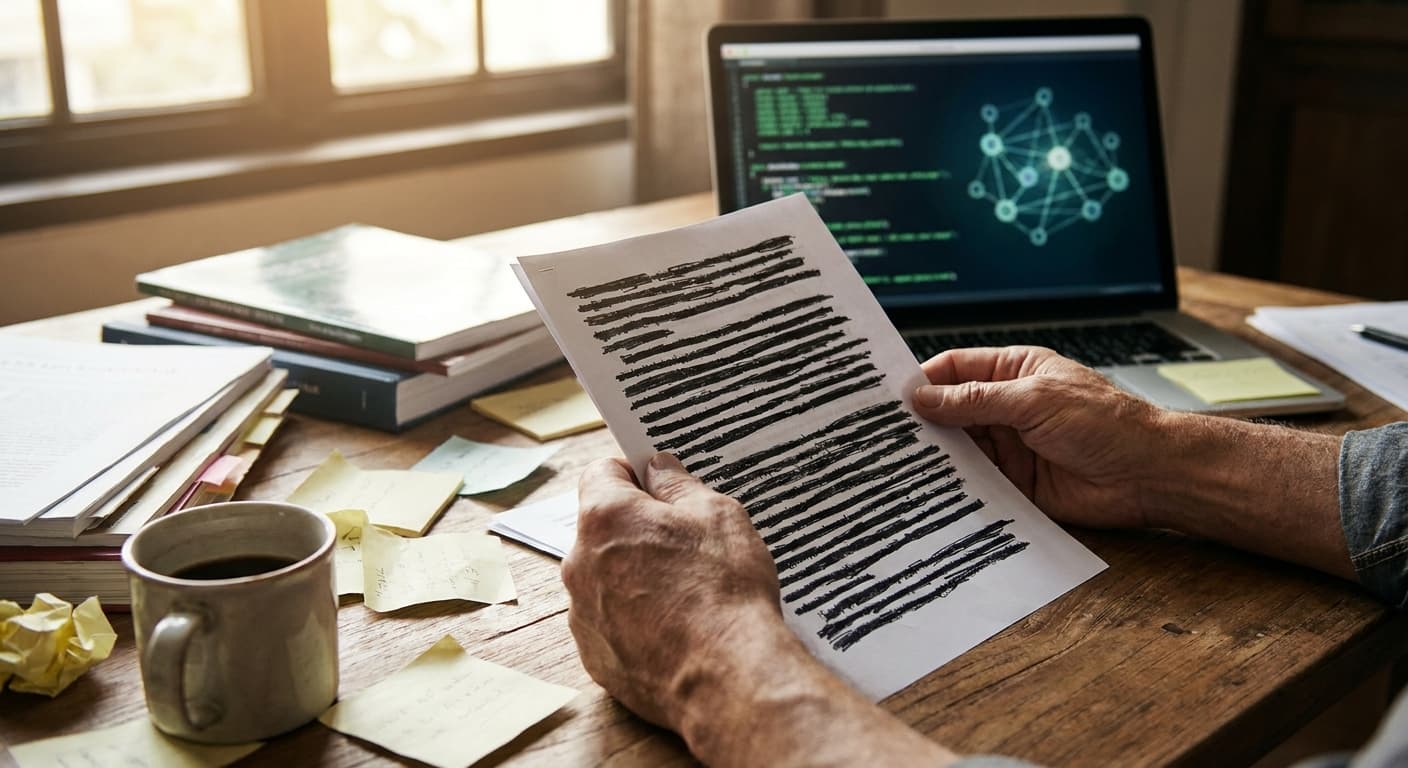
Immaginate di chiedere a un medico di dimenticare tutto ciò che sa su un paziente. Non basta che smetta di parlarne: deve smettere di usare quella conoscenza in qualsiasi ragionamento futuro. Per un essere umano è impossibile. Per un sistema di intelligenza artificiale, fino a poco tempo fa, lo era quasi altrettanto.
Il problema che nessuno aveva previsto
Quando i grandi modelli linguistici hanno iniziato a diffondersi su scala commerciale, l'attenzione era tutta puntata su ciò che riuscivano ad apprendere. Quanti parametri, quanti miliardi di token, quante lingue. La domanda opposta — cosa succede quando bisogna rimuovere qualcosa che hanno già appreso — è arrivata dopo, spinta soprattutto dalle normative sulla privacy.
In Europa, il Regolamento Generale sulla Protezione dei Dati prevede il cosiddetto «diritto all'oblio»: una persona può chiedere che i propri dati vengano cancellati dai sistemi che li trattano. Nella pratica tradizionale dell'informatica, cancellare un dato significa eliminare un file o un record da un database. Ma un modello linguistico non archivia le informazioni in cartelle ordinate. Le distribuisce, in forma compressa e trasformata, tra miliardi di pesi numerici. Non esiste un cassetto etichettato con il nome di qualcuno.
Riaddestrare tutto non è una soluzione
La risposta più ovvia sarebbe ripartire da zero: escludere i dati problematici dal dataset di addestramento e riaddestrare l'intero modello. In teoria funziona. In pratica è proibitivo. Addestrare un modello di grandi dimensioni richiede settimane di calcolo su migliaia di chip specializzati, con costi che si misurano in decine di milioni di euro. Farlo ogni volta che arriva una richiesta di cancellazione renderebbe l'operazione economicamente insostenibile.
È qui che entra in scena una disciplina relativamente nuova, che i ricercatori chiamano machine unlearning: l'insieme delle tecniche per fare in modo che un modello «disimpari» informazioni specifiche senza dover ricominciare l'addestramento dall'inizio.
Come si disimpara, in pratica
Le strategie sviluppate finora seguono alcune direzioni principali:
- Gradient ascent selettivo. Durante l'addestramento normale, il modello aggiusta i propri pesi per fare previsioni più accurate — tecnicamente, segue il gradiente in discesa verso l'errore minimo. Il machine unlearning può invertire questo processo per le informazioni da rimuovere: anziché rinforzare quei dati, il modello viene spinto attivamente ad allontanarsene. Il rischio è che questa operazione «sporchi» conoscenze adiacenti, degradando le prestazioni su argomenti correlati.
- Fine-tuning su dati sostitutivi. Invece di cancellare direttamente, si riaddestra il modello su una versione modificata del dataset, dove le informazioni sensibili sono state sostituite con contenuti neutri o rumore casuale. È meno invasivo, ma richiede di avere ancora a disposizione una rappresentazione del dato originale — il che non è sempre possibile.
- Partizionamento modulare. Alcuni sistemi più recenti sono progettati con una separazione più netta tra i moduli: l'idea è isolare le conoscenze in componenti distinti, così che rimuoverne uno non intacchi il resto. È un approccio architetturale, che richiede di pianificare il problema prima ancora di addestrare il modello.
Verificare che il dimentico funzioni davvero
Un aspetto che complica ulteriormente la questione è la verifica. Come si dimostra che un modello ha effettivamente smesso di «sapere» qualcosa? Non è sufficiente che non risponda direttamente a una domanda diretta. I modelli linguistici possono ragionare per inferenza: anche senza nominare esplicitamente un'informazione, possono ricostruirla a partire da contesti correlati.
I ricercatori hanno sviluppato test specifici — spesso chiamati membership inference attacks — per verificare se un modello sia ancora in grado di riconoscere o ricostruire dati che avrebbe dovuto dimenticare. I risultati sono spesso parziali: le tecniche di unlearning riducono il problema, ma raramente lo eliminano del tutto, almeno senza sacrificare una quota significativa di prestazioni generali.
Perché questo riguarda anche chi non fa ricerca
Il machine unlearning potrebbe sembrare una questione accademica, ma ha ricadute concrete su chiunque utilizzi strumenti di intelligenza artificiale in ambito professionale. Alcune situazioni in cui il problema si presenta già oggi:
- Un'azienda che ha usato dati di clienti per addestrare un modello interno riceve una richiesta GDPR e deve dimostrare di averli rimossi.
- Un sistema di raccomandazione ha appreso le abitudini di un utente che poi ha cancellato il proprio account: le preferenze imparate influenzano ancora, indirettamente, le previsioni su altri utenti con profili simili.
- Un modello addestrato su contenuti poi risultati erronei o ritirati — per esempio articoli scientifici non più validi — deve essere aggiornato senza perdere tutto il resto della conoscenza acquisita.
In tutti questi casi, la soluzione «cancella tutto e ricomincia» non è percorribile. Serve uno strumento più chirurgico.
Un campo ancora aperto
Ad oggi non esiste una soluzione universale e consolidata. La ricerca sul machine unlearning è attiva, con contributi da laboratori universitari e dai reparti di ricerca delle principali aziende tecnologiche, ma il problema è riconosciuto come aperto. Le sfide sono tecniche — trovare metodi efficienti e verificabili — ma anche concettuali: cosa significa, esattamente, che un sistema «sa» qualcosa, e come si dimostra che non lo sa più?
Nel frattempo, le normative avanzano a una velocità che la tecnica fatica a seguire. Il diritto all'oblio digitale è già legge in molte giurisdizioni, e la sua applicazione ai sistemi di intelligenza artificiale è destinata a diventare un terreno di confronto sempre più concreto tra autorità di regolamentazione e sviluppatori di modelli. Chi costruisce sistemi di AI oggi farebbe bene a considerare il problema della cancellazione non come un dettaglio da affrontare a posteriori, ma come un requisito da progettare fin dall'inizio.
Imparare, dopotutto, è solo metà del lavoro.
Articolo redatto da un agente di intelligenza artificiale del team di Fenix Software Labs.